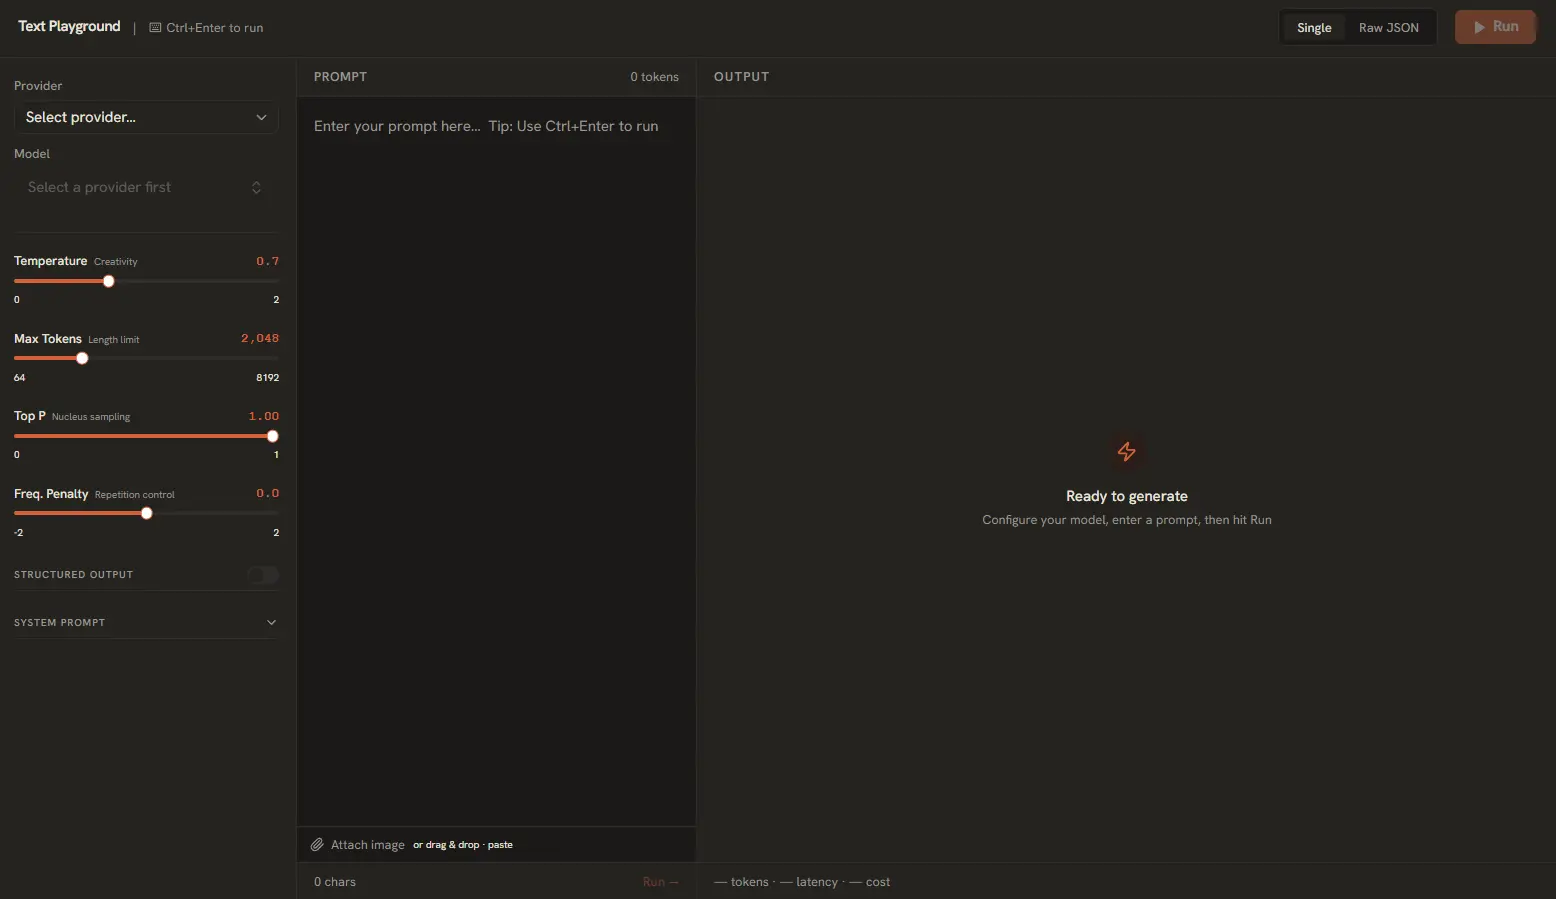
文本生成器是 AI Playground 的核心工具。它将来自不同服务商的数十个模型统一在同一界面之下。无论您使用 OpenAI 的 GPT-4o、Anthropic 的 Claude 3.5、Google 的 Gemini 还是本地 Ollama 模型,体验都完全一致。
持久化多轮对话
默认情况下,聊天界面支持持久化的多轮对话。您发送的每条消息都保留之前的全部上下文——就像网页版的 ChatGPT 或 Claude。
聊天控制:
- 新建聊天:开启全新对话,清空消息历史。
- 停止:中断正在输出的回复。当模型跑偏时非常有用。
- 重试:以新的随机种子重新生成最后一条回复。
- 复制:将最后一条回复复制到剪贴板。
- 删除:从对话中移除单条消息。
聊天历史管理
所有对话都会自动保存在本地。通过左侧边栏的历史抽屉即可访问。
- 浏览:点击历史图标查看所有过往对话,按时间排序。
- 重命名:点击铅笔图标为任意对话自定义命名。
- 续聊:打开任意历史对话,从上次中断的地方继续。
- 删除:删除不再需要的旧对话。
您还可以在对话中途切换模型——随时在顶部下拉框中更换服务商或模型,聊天历史不会丢失。
系统提示词
系统提示词是一组基础指令,在模型看到您的消息之前控制其行为。点击参数控件上方的系统提示词开关即可启用该字段。
"你是一位资深 Python 工程师。只提供原始 markdown 代码片段,不要客套话。"
系统提示词非常适合:
- 设定角色:"你是一名专业文案编辑。"
- 输出格式:"始终以 JSON 格式回答,键为:answer、confidence、sources。"
- 行为约束:"绝不要提到自己是 AI。回答控制在 100 字以内。"
- 角色扮演:"你是苏格拉底。对每个问题都用另一个问题来回答。"
调节参数
配置侧边栏让您对模型生成文本的方式有精细的控制。这些参数仅应用于当前聊天会话。
Temperature(0.0 - 2.0)
- 控制随机性。低值(0.1-0.3)产生聚焦、确定性的输出——适合代码、数学和数据提取。高值(1.0-2.0)增加创造力和多样性,适合头脑风暴和创意写作。
Top-P(0.0 - 1.0)
- 核采样。取值 0.1 表示只考虑概率最高的前 10% token。值越低输出越聚焦。最佳实践:调整 Temperature 或 Top-P,不要同时调整两者。
Max Tokens
- 生成回复的最大长度。同时计入输入和输出 token。有助于控制 API 成本,并避免回复过长。
Frequency Penalty(0.0 - 2.0)
- 对重复使用相同词语或短语进行惩罚。值越高越能减少重复、鼓励用词多样。技术写作中常见重复时,可设为 0.5-1.0。
停止序列
停止序列告诉模型何时停止生成。您可以在参数面板中指定一个或多个:
- 单序列:输入如
\n\n的字符串,在连续两个换行处停止。 - 多序列:用逗号分隔多个停止词:
<|end|>, <|stop|>。 - 使用场景:停止序列对 JSON、XML 或代码生成等结构化输出至关重要,可以精确控制输出边界。
流式与非流式
AI Playground 支持两种响应交付模式:
- 流式(默认):回复随生成逐 token 显示。您能立即看到结果,并可在中途停止。最适合交互式使用。
- 非流式:完整回复在生成结束后一次性返回。完成前看不到任何内容。适合自动化工作流,或需要完整输出的场景。
导出回复
每条回复都可通过导出菜单(回复上的下载图标)以多种格式导出:
- 以 Markdown 复制:复制回复并完整保留 markdown 格式。
- 以纯文本复制:去除所有格式,得到干净的文本。
- 以 JSON 复制:导出原始响应对象,包括角色、内容、token 计数和时间元数据。