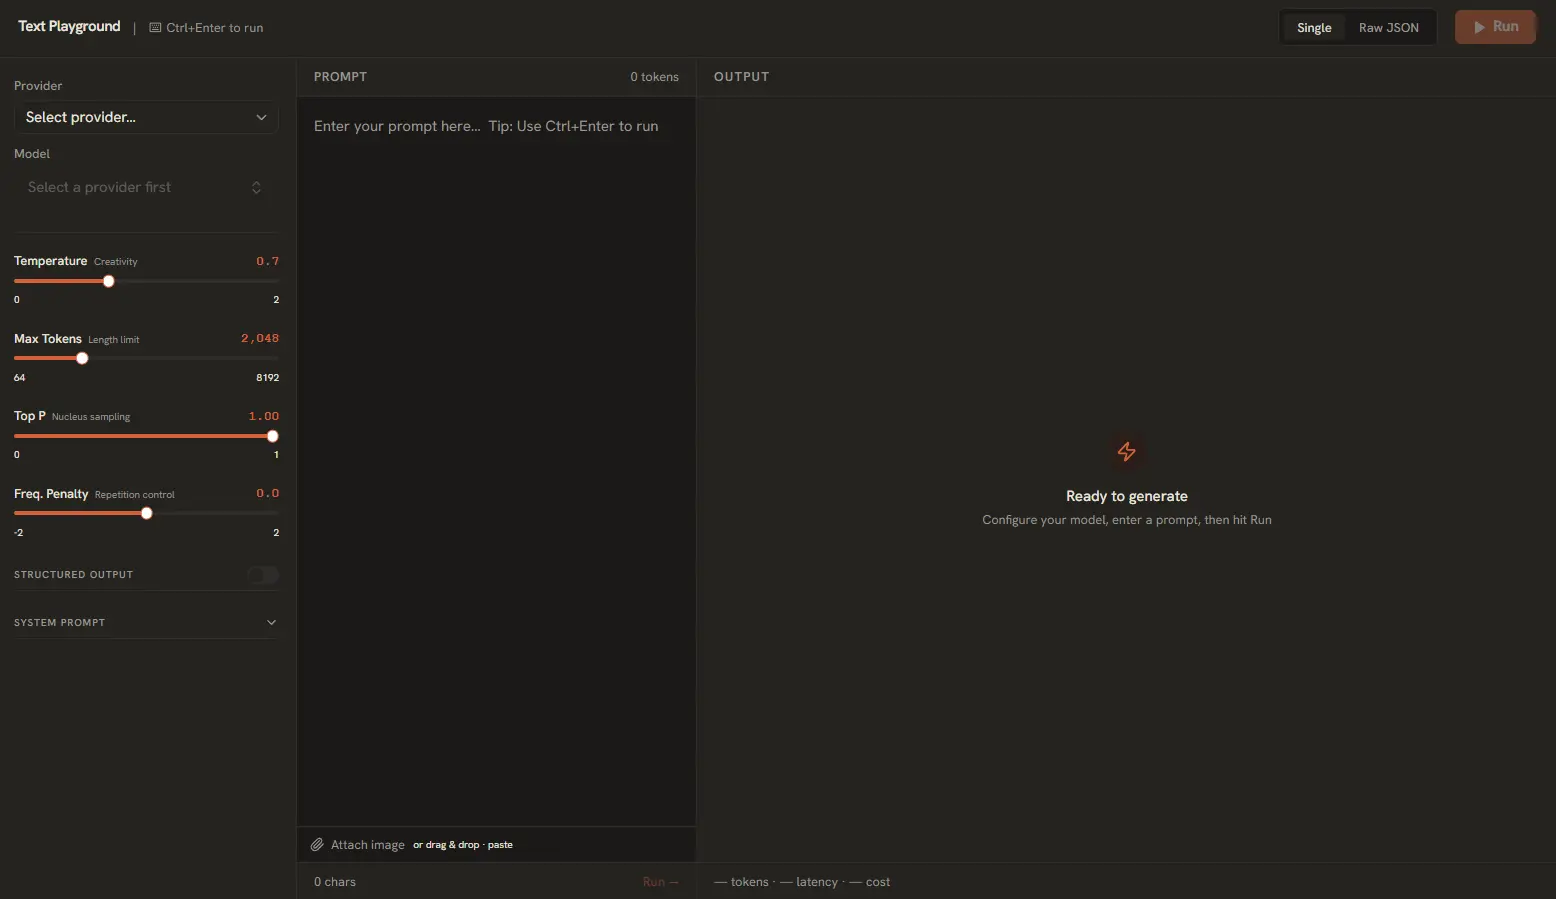
O gerador de texto é a principal ferramenta do AI Playground. Ele unifica dezenas de modelos de provedores diferentes sob uma única interface consistente. Seja usando o GPT-4o da OpenAI, o Claude 3.5 da Anthropic, o Gemini do Google ou um modelo local do Ollama, a experiência é a mesma.
Chat multi-turno persistente
Por padrão, a interface de chat suporta conversas multi-turno persistentes. Cada mensagem que você envia mantém todo o contexto do que foi dito antes — como o ChatGPT ou o Claude na web.
Controles do chat:
- Novo chat: inicia uma conversa nova e limpa o histórico de mensagens.
- Parar: interrompe uma resposta em andamento. Útil quando o modelo sai do rumo.
- Tentar de novo: regenera a última resposta com uma nova seed aleatória.
- Copiar: copia a última resposta para a área de transferência.
- Excluir: remove mensagens individuais da conversa.
Gerenciamento do histórico de chats
Todas as suas conversas são salvas automaticamente em local storage. Você pode acessá-las pela gaveta de histórico na barra lateral esquerda.
- Navegar: clique no ícone de Histórico para ver todas as conversas anteriores, ordenadas por data.
- Renomear: clique no ícone de lápis para dar um nome personalizado a qualquer conversa.
- Retomar: abra qualquer conversa anterior e continue de onde parou.
- Excluir: remova conversas antigas que não precisa mais.
Você também pode trocar de modelo no meio da conversa — mude o provedor ou o modelo no menu suspenso do topo a qualquer momento sem perder o histórico do chat.
Prompts de sistema
Um prompt de sistema é um conjunto de instruções fundamentais que controla o comportamento do modelo antes de ele ver suas mensagens. Você pode ativar o campo de prompt de sistema pelo interruptor Prompt de sistema acima dos controles de parâmetros.
"Você é um engenheiro Python experiente. Forneça apenas trechos de código em markdown puro, sem cortesias."
Prompts de sistema são ideais para:
- Definir o papel: "Você é um editor de textos profissional."
- Formato de saída: "Sempre responda em formato JSON com as chaves: answer, confidence, sources."
- Restrições de comportamento: "Nunca mencione que é uma IA. Mantenha as respostas com menos de 100 palavras."
- Personificação: "Você é Sócrates. Responda a cada pergunta com outra pergunta."
Ajustando os parâmetros
O painel lateral de configuração dá controle fino sobre como o modelo gera o texto. Esses parâmetros valem apenas para a sessão de chat atual.
Temperature (0.0 - 2.0)
- Controla a aleatoriedade. Valores baixos (0.1-0.3) produzem saídas focadas e determinísticas — ideais para código, matemática e extração de dados. Valores altos (1.0-2.0) aumentam a criatividade e a variedade, úteis para brainstorming e escrita criativa.
Top-P (0.0 - 1.0)
- Amostragem nucleus. Um valor de 0.1 significa que apenas os 10% de tokens mais prováveis são considerados. Valores baixos tornam a saída mais focada. Boa prática: ajuste Temperature ou Top-P, não ambos ao mesmo tempo.
Max Tokens
- O comprimento máximo da resposta gerada. Conta tokens de entrada e saída. Útil para manter os custos de API previsíveis e evitar respostas longas demais.
Frequency Penalty (0.0 - 2.0)
- Penaliza a repetição das mesmas palavras ou frases. Valores mais altos reduzem a repetição e incentivam vocabulário variado. Use 0.5-1.0 para textos técnicos com muita repetição.
Sequências de parada
Sequências de parada indicam ao modelo quando parar de gerar. Você pode especificar uma ou mais no painel de parâmetros:
- Sequência única: insira uma string como
\n\npara parar em quebras de linha duplas. - Várias sequências: separe múltiplas palavras de parada com vírgulas:
<|end|>, <|stop|>. - Caso de uso: são essenciais para saídas estruturadas como JSON, XML ou geração de código, onde você precisa de precisão.
Streaming vs. não streaming
O AI Playground suporta dois modos de entrega da resposta:
- Streaming (padrão): a resposta aparece token a token à medida que é gerada. Você vê os resultados imediatamente e pode interromper no meio. Melhor para uso interativo.
- Não streaming: a resposta completa chega de uma vez, após a geração terminar. Você não vê nada até que esteja pronta. Útil para fluxos automatizados ou quando precisa da saída completa.
Exportando respostas
Cada resposta pode ser exportada em vários formatos pelo menu de exportação (o ícone de download em qualquer resposta):
- Copiar como Markdown: copia a resposta mantendo toda a formatação markdown.
- Copiar como texto simples: remove toda a formatação para colar texto limpo.
- Copiar como JSON: exporta o objeto bruto da resposta, incluindo papel, conteúdo, contagem de tokens e metadados de tempo.