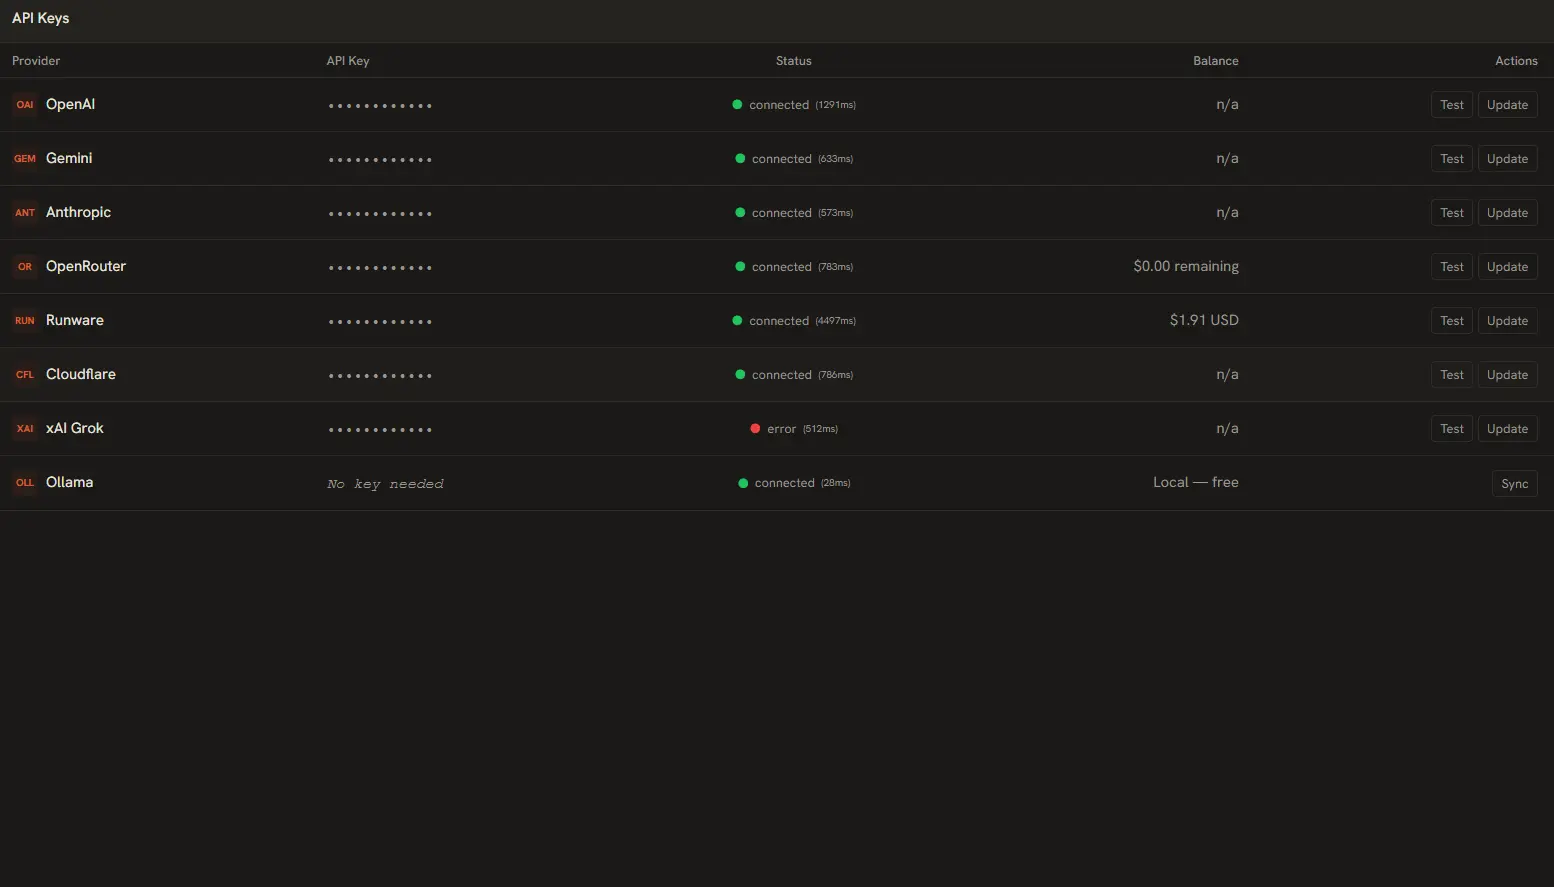
O AI Playground é uma ponte entre o seu computador e os modelos de IA mais poderosos do mundo. Para usá-los, você precisa conectar provedores via chaves de API. Este guia percorre cada provedor, como conseguir suas chaves e como configurá-las corretamente.
Nota de privacidade: todas as chaves que você inserir são armazenadas estritamente no banco de dados SQLite local do app. Elas nunca são enviadas aos nossos servidores nem registradas fora do aplicativo.
Acessando o painel de chaves de API
Todo o gerenciamento de provedores acontece em um único lugar:
- Abra o AI Playground.
- Clique no ícone Chaves de API / Provedores na barra lateral (o ícone de chave).
- Você verá a lista de todos os provedores suportados, cada um com um campo de entrada e um botão Testar.
Configuração provedor por provedor
OpenAI
- Oferece GPT-4o, GPT-4o-mini, GPT-4, GPT-3.5-Turbo e mais. Ideal para geração de texto geral, código e raciocínio.
- 1. Acesse platform.openai.com/api-keys ↗, faça login ou crie uma conta.
- 2. Clique em Create new secret key.
- 3. Dê um nome (ex.: "AI Playground") e copie a chave gerada.
- 4. Cole-a no campo OpenAI do AI Playground e clique em Testar.
Anthropic
- Oferece Claude 3.5 Sonnet, Claude 3 Opus e Claude 3 Haiku. Excelente para escritos longos, análise e diálogos com nuances.
- 1. Acesse console.anthropic.com ↗ e crie uma conta.
- 2. Navegue até API Keys no menu lateral.
- 3. Clique em Create API Key.
- 4. Copie a chave (começa com
sk-ant-) e cole-a no campo Anthropic. - 5. Clique em Testar para verificar.
Google Gemini
- Oferece Gemini 2.0 Flash, Gemini 1.5 Pro e Gemini 1.5 Flash. Rápido e econômico, com um plano gratuito generoso.
- 1. Acesse aistudio.google.com/apikey ↗.
- 2. Faça login com sua conta Google.
- 3. Clique em Create API Key.
- 4. Copie a chave e cole-a no campo Gemini do AI Playground.
- 5. Clique em Testar para confirmar a conexão.
Cloudflare Workers AI
- Acesso a modelos de código aberto executados na rede global da Cloudflare. Requer um token de API e um ID de conta.
- 1. Acesse dash.cloudflare.com/profile/api-tokens ↗.
- 2. Clique em Create Token e use o modelo Workers AI.
- 3. Copie o token gerado.
- 4. Encontre seu Account ID na página de visão geral do painel da Cloudflare.
- 5. No AI Playground, informe-os no campo Cloudflare neste formato:
API_TOKEN:ACCOUNT_ID - 6. Clique em Testar para verificar.
Runware
- Geração de imagens via Stable Diffusion 3 e modelos FLUX. Inferência em menos de um segundo, custo muito baixo. Suporta prompts negativos e todos os parâmetros avançados.
- 1. Acesse runware.ai ↗ e crie uma conta.
- 2. Navegue até a seção API do seu painel.
- 3. Copie sua chave de API.
- 4. Cole-a no campo Runware e clique em Testar.
OpenRouter
- Gateway de API unificado para centenas de modelos de dezenas de provedores. Uma única fatura, acesso a tudo.
- 1. Acesse openrouter.ai/keys ↗ e faça login.
- 2. Clique em Create Key.
- 3. Copie a chave e cole-a no campo OpenRouter.
- 4. Clique em Testar. O OpenRouter dá acesso a modelos da Meta, Mistral, Google e mais com uma única integração.
AI/ML
- Acesso a mais de 100 modelos da OpenAI, Anthropic, Google, Meta e outros por uma API unificada com cobrança por token. Também suporta geração de imagens.
- 1. Acesse aimlapi.com ↗ e crie uma conta.
- 2. Navegue até API Keys no seu painel.
- 3. Copie sua chave de API.
- 4. Cole-a no campo AI/ML e clique em Testar.
NVIDIA
- Plataforma de inferência corporativa com 55+ modelos, incluindo Llama, Mistral, Stable Diffusion e os modelos da própria NVIDIA. Plano gratuito com limites de taxa.
- 1. Acesse build.nvidia.com ↗ e crie uma conta.
- 2. Navegue até a sua seção de chaves de API.
- 3. Gere e copie uma chave.
- 4. Cole-a no campo NVIDIA e clique em Testar.
Hugging Face
- Acesso a modelos de código aberto do ecossistema Hugging Face — DeepSeek, Llama, Qwen, Mistral, Gemma e muitos outros via API de roteamento de inferência.
- 1. Acesse huggingface.co/settings/tokens ↗ e faça login.
- 2. Clique em Create new token.
- 3. Escolha um nome e clique em Generate.
- 4. Copie o token e cole-o no campo Hugging Face.
- 5. Clique em Testar para verificar a conexão.
Configurando o Ollama (IA local)
O Ollama é o único provedor que não exige chave de API. Ele roda inteiramente na sua máquina, de graça.
- Baixe e instale o Ollama ↗ para a sua plataforma.
- Abra um terminal e baixe um modelo:
ollama pull llama3.2 - Verifique se o serviço do Ollama está em execução (você o verá na bandeja do sistema ou na barra de menus).
- Abra o AI Playground. O cartão do Ollama no painel deve ser detectado e ficar verde automaticamente.
O AI Playground consulta o Ollama em http://127.0.0.1:11434 por padrão. Modelos locais populares incluem llama3.2, mistral, codellama e phi3.
Testando e verificando conexões
Depois de inserir uma chave, sempre clique no botão Testar. O app envia uma requisição leve de autenticação ao provedor e informa o resultado:
- Ponto verde: conexão bem-sucedida. O provedor está pronto para uso.
- Ponto vermelho: falha na conexão. Verifique se a chave não tem erros de digitação, espaços extras ou expiração.
- Ponto amarelo (apenas Ollama): o processo do Ollama não está em execução. Inicie o serviço do Ollama.
Editando e removendo chaves
Para atualizar ou remover a chave de um provedor:
- Vá ao painel Chaves de API / Provedores.
- Para substituir uma chave: limpe o campo, cole a nova e clique em Testar.
- Para remover uma chave: clique no ícone de lixeira ao lado do nome do provedor e confirme no diálogo.
Dica: se você troca suas chaves de API periodicamente (recomendado por segurança), pode atualizá-las aqui a qualquer momento sem reinstalar o app.
Entendendo o catálogo de preços
O AI Playground busca um catálogo de preços em tempo real do OpenRouter e da Runware a cada inicialização do app. O preço do AI/ML API e do NVIDIA NIM é calculado a partir do uso de tokens, com tarifas fixas para todos os modelos conhecidos.
Ao executar um prompt, o painel usa esse catálogo para estimar seus gastos em tempo real. O gráfico de gastos do painel acompanha seus custos diários e semanais em todos os provedores hospedados.
Os modelos locais via Ollama são totalmente gratuitos — rodam no seu hardware e não geram custos de API.