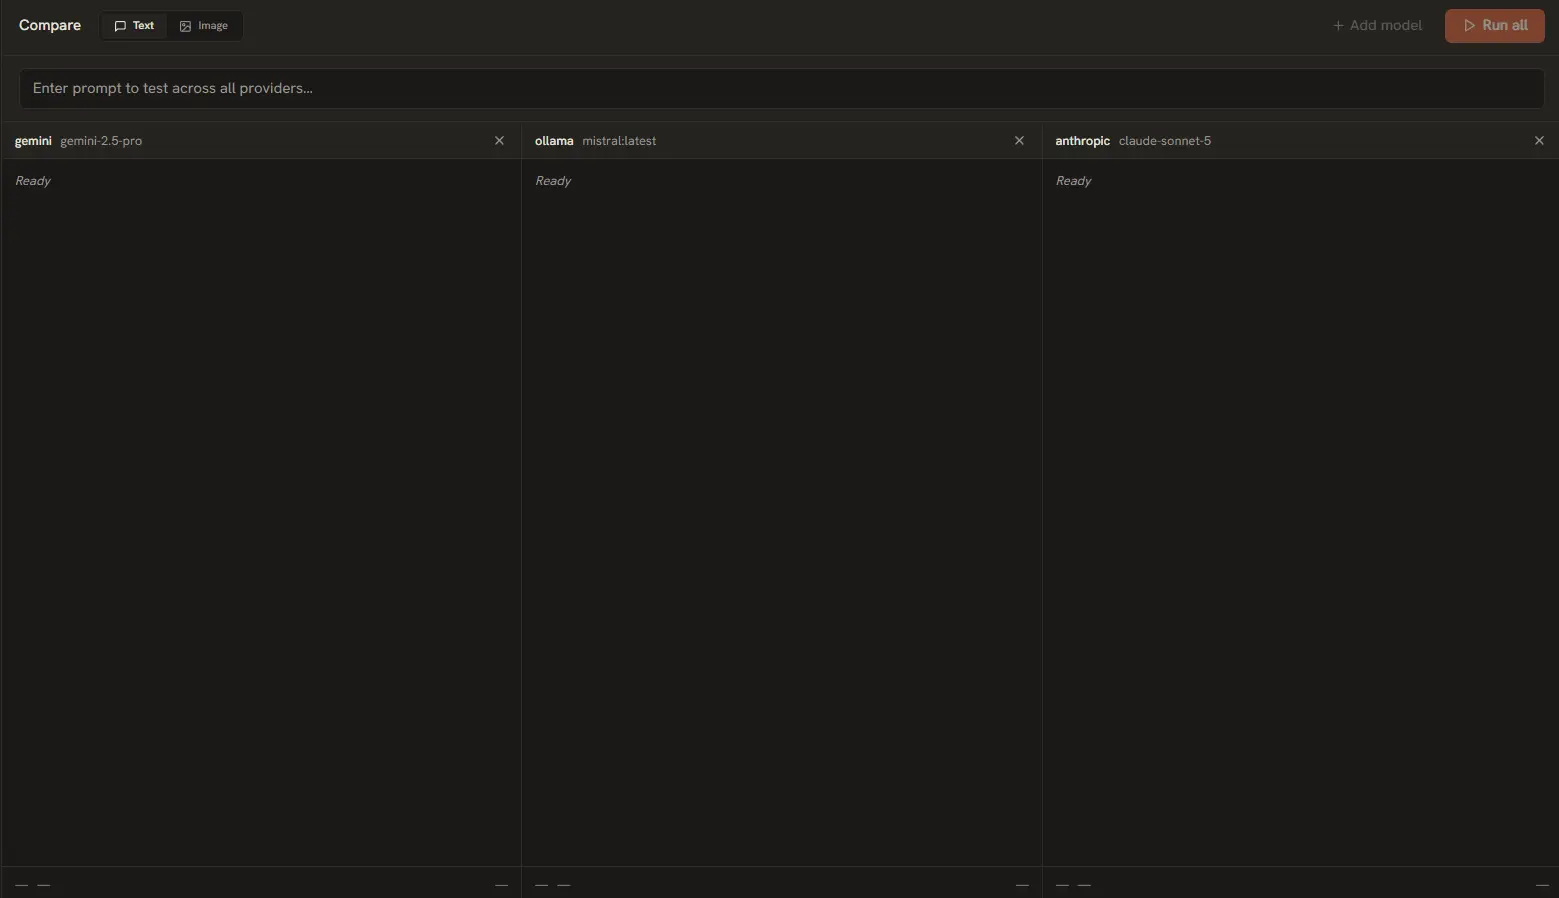
La fonctionnalité signature d’AI Playground est l’interface de comparaison. Au lieu d’ouvrir plusieurs onglets du navigateur et d’exécuter les prompts un par un, testez les modèles côte à côte dans une seule vue. C’est essentiel pour optimiser les coûts, comparer la qualité et mesurer la vitesse.
Quand utiliser le mode comparaison
Le mode comparaison est idéal pour répondre à ces questions :
- Coût vs qualité : GPT-4o vaut-il 10 fois le prix de Gemini 2.0 Flash pour ma tâche précise ?
- Vitesse : quel modèle répond le plus vite pour des applications temps réel ?
- Format de sortie : Claude formate-t-il mieux le JSON que GPT ? Gemini suit-il les prompts système plus rigoureusement ?
- Choix de modèle : quel modèle open source via Ollama se rapproche le plus d’un modèle cloud payant ?
Configurer une comparaison
Suivez ces étapes pour votre première comparaison :
- Cliquez sur l’icône Comparer dans la barre latérale (l’icône à deux colonnes).
- Choisissez le mode Texte ou Image via le commutateur en haut à droite.
- Cliquez sur + Ajouter une colonne de modèle. Vous pouvez ajouter jusqu’à 3 colonnes.
- Dans chaque colonne, configurez : le fournisseur (ex. OpenAI, Anthropic, Google), le modèle (ex. gpt-4o, claude-3.5-sonnet) et les paramètres individuels (Temperature, Max Tokens, etc.) par colonne.
- Tapez votre prompt dans la zone de saisie partagée en bas.
- Cliquez sur Exécuter pour envoyer le prompt à toutes les colonnes simultanément.
Astuce : réglez chaque colonne sur la même Temperature et les mêmes Max Tokens pour une comparaison équitable. Ne variez les paramètres qu’à dessein, pour tester des configurations précises.
Lire les résultats
Une fois toutes les colonnes terminées, trois métriques apparaissent sous chaque réponse :
Latence de réponse (ms)
- Temps jusqu’au premier token. Plus bas = mieux pour le chat en temps réel. Montre quelle combinaison fournisseur/modèle répond le plus vite sur le réseau.
Analyse des coûts
- Coût exact de chaque réponse d’après le catalogue de tarifs en direct. Affiche les tarifs pour 1 000 tokens et le coût total selon les tokens exacts d’entrée/sortie.
Évaluation de la qualité
- Indicateurs visuels de la structure de la sortie — conformité du format, longueur de la réponse et fidélité du modèle aux instructions.
Enregistrer les configurations de comparaison
Trouvé une combinaison gagnante ? Enregistrez votre configuration pour la réutiliser :
- Configurez vos colonnes avec les fournisseurs, modèles et paramètres souhaités.
- Cliquez sur Enregistrer la config en haut de la vue Comparer.
- Donnez-lui un nom (ex. « GPT-4o vs Claude vs Gemini — génération de code »).
- Les configs enregistrées apparaissent dans le menu déroulant Comparaisons enregistrées pour un rechargement en un clic.
Comparaison multi-tours
Vous pouvez exécuter plusieurs prompts dans la même session de comparaison. Les résultats de chaque tour sont conservés dans l’historique des colonnes, ce qui permet de comparer la réponse des modèles à une série de prompts liés. Utile pour tester la cohérence conversationnelle, le suivi des instructions sur plusieurs tours ou le raffinement itératif des prompts.