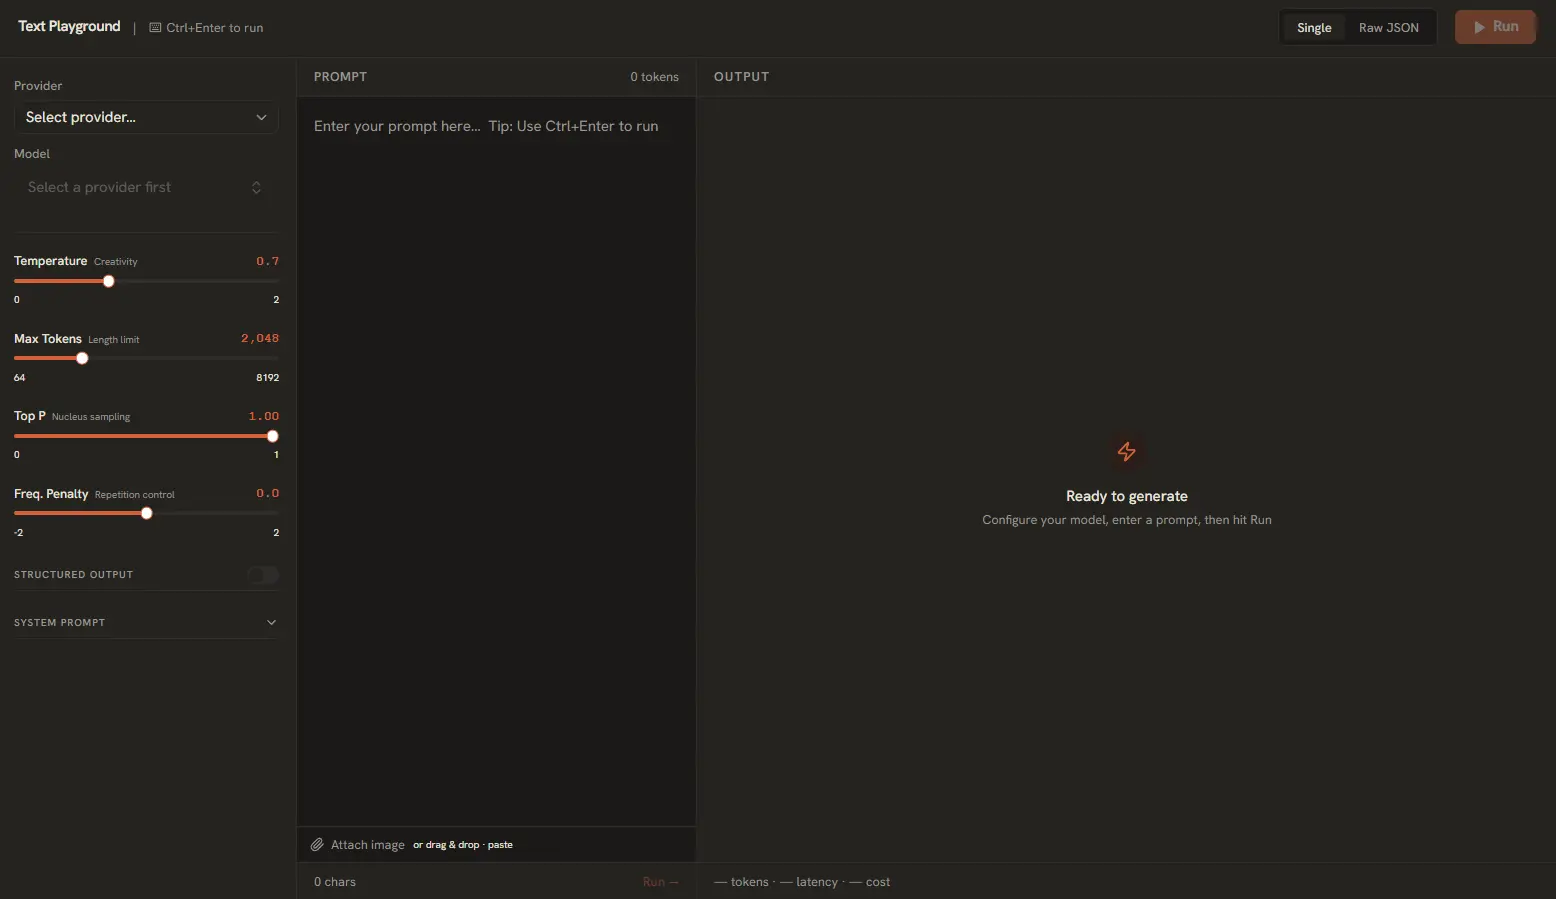
El generador de texto es la herramienta principal de AI Playground. Unifica decenas de modelos de distintos proveedores bajo una única interfaz coherente. Tanto si usas GPT-4o de OpenAI, Claude 3.5 de Anthropic, Gemini de Google o un modelo local de Ollama, la experiencia es la misma.
Chat multi-turno persistente
Por defecto, la interfaz de chat admite conversaciones multi-turno persistentes. Cada mensaje conserva todo el contexto de lo dicho antes, igual que ChatGPT o Claude en la web.
Controles del chat:
- Nuevo chat: inicia una conversación nueva y borra el historial.
- Detener: corta una respuesta en curso. Útil si el modelo se desvía.
- Reintentar: regenera la última respuesta con una nueva semilla aleatoria.
- Copiar: copia la última respuesta al portapapeles.
- Eliminar: borra mensajes individuales de la conversación.
Gestión del historial de chats
Todas tus conversaciones se guardan automáticamente en local. Accede a ellas desde el cajón de historial de la barra lateral.
- Explorar: haz clic en el icono de historial para ver todas las conversaciones pasadas, ordenadas por fecha.
- Renombrar: haz clic en el icono de lápiz para dar un nombre personalizado a cualquier conversación.
- Retomar: abre cualquier conversación anterior y continúa donde la dejaste.
- Eliminar: borra conversaciones que ya no necesites.
También puedes cambiar de modelo a mitad de conversación: cambia el proveedor o modelo en el desplegable superior sin perder el historial del chat.
Prompts de sistema
Un prompt de sistema es un conjunto de instrucciones fundamentales que controla el comportamiento del modelo antes de ver tus mensajes. Activa el campo con el interruptor Prompt de sistema sobre los controles de parámetros.
"Eres un ingeniero Python experto. Proporciona solo fragmentos de código en markdown sin cortesías."
Los prompts de sistema son ideales para:
- Definir el rol: "Eres un editor de textos profesional."
- Formato de salida: "Responde siempre en JSON con las claves: answer, confidence, sources."
- Restricciones de conducta: "Nunca menciones que eres una IA. Mantén las respuestas en menos de 100 palabras."
- Personificación: "Eres Sócrates. Responde a cada pregunta con otra pregunta."
Ajustar los parámetros
El panel lateral de configuración te da control fino sobre cómo el modelo genera el texto. Estos parámetros se aplican solo a la sesión de chat actual.
Temperature (0.0 - 2.0)
- Controla la aleatoriedad. Valores bajos (0.1-0.3) producen salidas concentradas y deterministas, ideales para código, mates y extracción de datos. Valores altos (1.0-2.0) aumentan la creatividad y la variedad, útiles para lluvia de ideas y escritura creativa.
Top-P (0.0 - 1.0)
- Muestreo nuclear. Un valor de 0.1 significa que solo se consideran el 10 % de tokens más probables. Valores bajos concentran la salida. Buenas prácticas: ajusta Temperature o Top-P, no ambos a la vez.
Max Tokens
- Longitud máxima de la respuesta generada. Cuenta tokens de entrada y salida. Útil para mantener los costes predecibles y evitar respuestas demasiado largas.
Frequency Penalty (0.0 - 2.0)
- Penaliza la repetición de las mismas palabras o frases. Valores altos reducen la repetición y fomentan vocabulario variado. Configura 0.5-1.0 para textos técnicos con repeticiones frecuentes.
Secuencias de parada
Las secuencias de parada indican al modelo cuándo dejar de generar. Puedes especificar una o varias en el panel de parámetros:
- Secuencia única: introduce una cadena como
\n\npara parar en los dobles saltos de línea. - Varias secuencias: separa varias palabras de parada con comas:
<|end|>, <|stop|>. - Caso de uso: son esenciales para salidas estructuradas como JSON, XML o generación de código donde necesitas precisión.
Streaming frente a no streaming
AI Playground admite dos modos de entrega de la respuesta:
- Streaming (por defecto): la respuesta aparece token a token a medida que se genera. Ves los resultados de inmediato y puedes cortar a mitad. Lo mejor para uso interactivo.
- No streaming: la respuesta completa llega de una vez al terminar la generación. No ves nada hasta que está lista. Útil para flujos automatizados o cuando necesitas la salida completa.
Exportar respuestas
Cada respuesta puede exportarse en varios formatos desde el menú de exportación (el icono de descarga de cualquier respuesta):
- Copiar como Markdown: copia la respuesta conservando todo el formato markdown.
- Copiar como texto plano: elimina todo el formato para pegar texto limpio.
- Copiar como JSON: exporta el objeto de respuesta completo con rol, contenido, recuento de tokens y metadatos de tiempo.