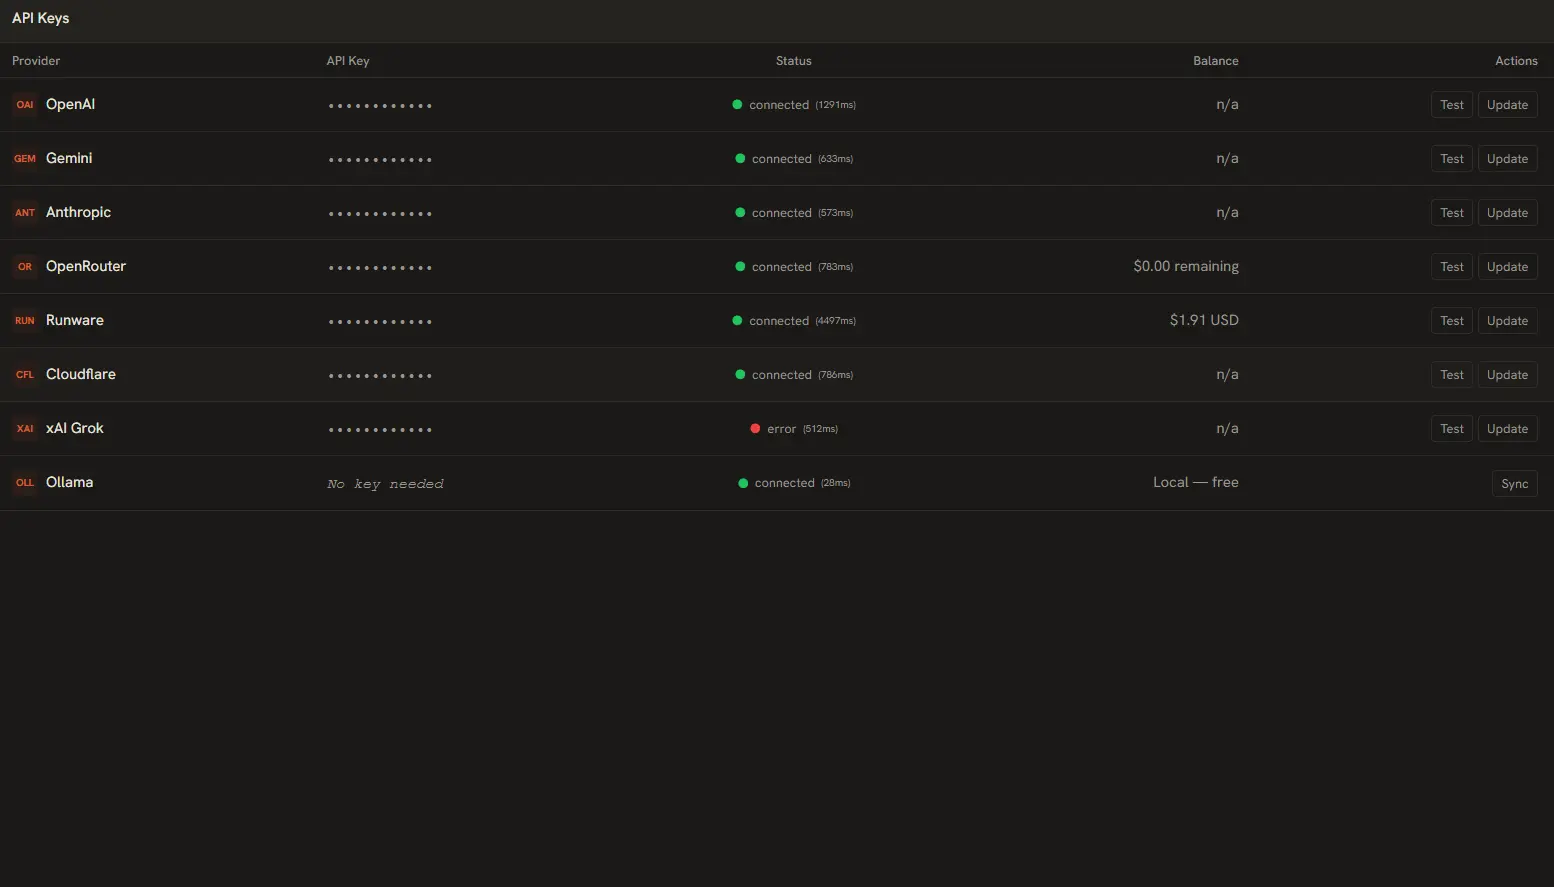
AI Playground es un puente entre tu ordenador y los modelos de IA más potentes del mundo. Para usarlos necesitas conectar proveedores mediante claves de API. Esta guía repasa cada proveedor, cómo conseguir tus claves y cómo configurarlas correctamente.
Nota de privacidad: todas las claves que introduzcas se guardan estrictamente en la base de datos SQLite local de la app. Nunca se envían a nuestros servidores ni se registran fuera de la app.
Acceder al panel de claves de API
Toda la gestión de proveedores ocurre en un único lugar:
- Abre AI Playground.
- Haz clic en el icono Claves de API / Proveedores de la barra lateral (el icono de llave).
- Verás la lista de todos los proveedores compatibles, cada uno con su campo de entrada y un botón Probar.
Configuración proveedor por proveedor
OpenAI
- Ofrece GPT-4o, GPT-4o-mini, GPT-4, GPT-3.5-Turbo y más. Ideal para generación de texto general, código y razonamiento.
- 1. Ve a platform.openai.com/api-keys ↗ e inicia sesión o crea una cuenta.
- 2. Haz clic en Create new secret key.
- 3. Ponle un nombre (p. ej. "AI Playground") y copia la clave generada.
- 4. Pégala en el campo de OpenAI en AI Playground y pulsa Probar.
Anthropic
- Ofrece Claude 3.5 Sonnet, Claude 3 Opus y Claude 3 Haiku. Excelente para escritura extensa, análisis y diálogo matizado.
- 1. Ve a console.anthropic.com ↗ y crea una cuenta.
- 2. Entra en API Keys en el menú lateral.
- 3. Haz clic en Create API Key.
- 4. Copia la clave (empieza por
sk-ant-) y pégala en el campo de Anthropic. - 5. Pulsa Probar para verificar.
Google Gemini
- Ofrece Gemini 2.0 Flash, Gemini 1.5 Pro y Gemini 1.5 Flash. Rápido y económico, con un plan gratuito generoso.
- 1. Ve a aistudio.google.com/apikey ↗.
- 2. Inicia sesión con tu cuenta de Google.
- 3. Haz clic en Create API Key.
- 4. Copia la clave y pégala en el campo de Gemini.
- 5. Pulsa Probar para confirmar la conexión.
Cloudflare Workers AI
- Acceso a modelos de código abierto en la red global de Cloudflare. Requiere un token de API y un ID de cuenta.
- 1. Ve a dash.cloudflare.com/profile/api-tokens ↗.
- 2. Haz clic en Create Token y usa la plantilla Workers AI.
- 3. Copia el token generado.
- 4. Localiza tu Account ID en la página de resumen del panel de Cloudflare.
- 5. En AI Playground, introdúcelos en el campo de Cloudflare con el formato:
API_TOKEN:ACCOUNT_ID - 6. Pulsa Probar para verificar.
Runware
- Generación de imágenes con Stable Diffusion 3 y modelos FLUX. Inferencia en menos de un segundo y coste muy bajo. Admite prompts negativos y todos los parámetros avanzados.
- 1. Ve a runware.ai ↗ y crea una cuenta.
- 2. Entra en la sección API de tu panel.
- 3. Copia tu clave de API.
- 4. Pégala en el campo de Runware y pulsa Probar.
OpenRouter
- Pasarela de API unificada a cientos de modelos de decenas de proveedores. Una sola factura, acceso a todo.
- 1. Ve a openrouter.ai/keys ↗ e inicia sesión.
- 2. Haz clic en Create Key.
- 3. Copia la clave y pégala en el campo de OpenRouter.
- 4. Pulsa Probar. OpenRouter te da acceso a modelos de Meta, Mistral, Google y más con una sola integración.
AI/ML
- Más de 100 modelos de OpenAI, Anthropic, Google, Meta y otros mediante una API unificada con facturación por token. También admite generación de imágenes.
- 1. Ve a aimlapi.com ↗ y crea una cuenta.
- 2. Entra en API Keys de tu panel.
- 3. Copia tu clave de API.
- 4. Pégala en el campo de AI/ML y pulsa Probar.
NVIDIA
- Plataforma de inferencia de nivel empresarial con más de 55 modelos, incluidos Llama, Mistral, Stable Diffusion y modelos propios de NVIDIA. Plan gratuito con límites de uso.
- 1. Ve a build.nvidia.com ↗ y crea una cuenta.
- 2. Entra en tu sección de claves de API.
- 3. Genera y copia una clave.
- 4. Pégala en el campo de NVIDIA y pulsa Probar.
Hugging Face
- Acceso a modelos de código abierto del ecosistema Hugging Face: DeepSeek, Llama, Qwen, Mistral, Gemma y muchos más vía la API de router de inferencia.
- 1. Ve a huggingface.co/settings/tokens ↗ e inicia sesión.
- 2. Haz clic en Create new token.
- 3. Elige un nombre y pulsa Generate.
- 4. Copia el token y pégalo en el campo de Hugging Face.
- 5. Pulsa Probar para verificar la conexión.
Configurar Ollama (IA local)
Ollama es el único proveedor que no necesita clave de API. Se ejecuta por completo en tu máquina, gratis.
- Descarga e instala Ollama ↗ para tu plataforma.
- Abre una terminal y descarga un modelo:
ollama pull llama3.2 - Asegúrate de que el servicio de Ollama está en ejecución (lo verás en la bandeja del sistema o la barra de menús).
- Abre AI Playground. La tarjeta de Ollama del panel debería detectarse y ponerse en verde automáticamente.
AI Playground consulta Ollama en http://127.0.0.1:11434 por defecto. Modelos locales populares: llama3.2, mistral, codellama y phi3.
Probar y verificar conexiones
Tras introducir una clave, pulsa siempre el botón Probar. La app enviará una petición ligera de autenticación al proveedor e informará del resultado:
- Punto verde: conexión correcta; el proveedor está listo para usarse.
- Punto rojo: error de conexión. Revisa la clave por si tiene erratas, espacios o ha caducado.
- Punto amarillo (solo Ollama): el proceso de Ollama no está en ejecución. Arranca el servicio de Ollama.
Editar y eliminar claves
Para actualizar o eliminar la clave de un proveedor:
- Ve al panel Claves de API / Proveedores.
- Para reemplazar una clave: borra el campo, pega la nueva y pulsa Probar.
- Para eliminar una clave: haz clic en el icono de papelera junto al nombre del proveedor y confirma en el diálogo.
Consejo: si rotas tus claves de API con regularidad (recomendado por seguridad), puedes actualizarlas aquí en cualquier momento sin reinstalar la app.
Entender el catálogo de precios
AI Playground descarga un catálogo de precios en vivo de OpenRouter y Runware cada vez que arranca la app. El precio de AI/ML API y NVIDIA NIM se calcula a partir de los tokens con tarifas fijas para todos los modelos conocidos.
Al ejecutar un prompt, el panel usa este catálogo para estimar tu gasto en tiempo real. El gráfico de gasto del panel registra tus costes diarios y semanales de todos los proveedores alojados.
Los modelos locales vía Ollama son completamente gratis: se ejecutan en tu hardware y no generan ningún coste de API.