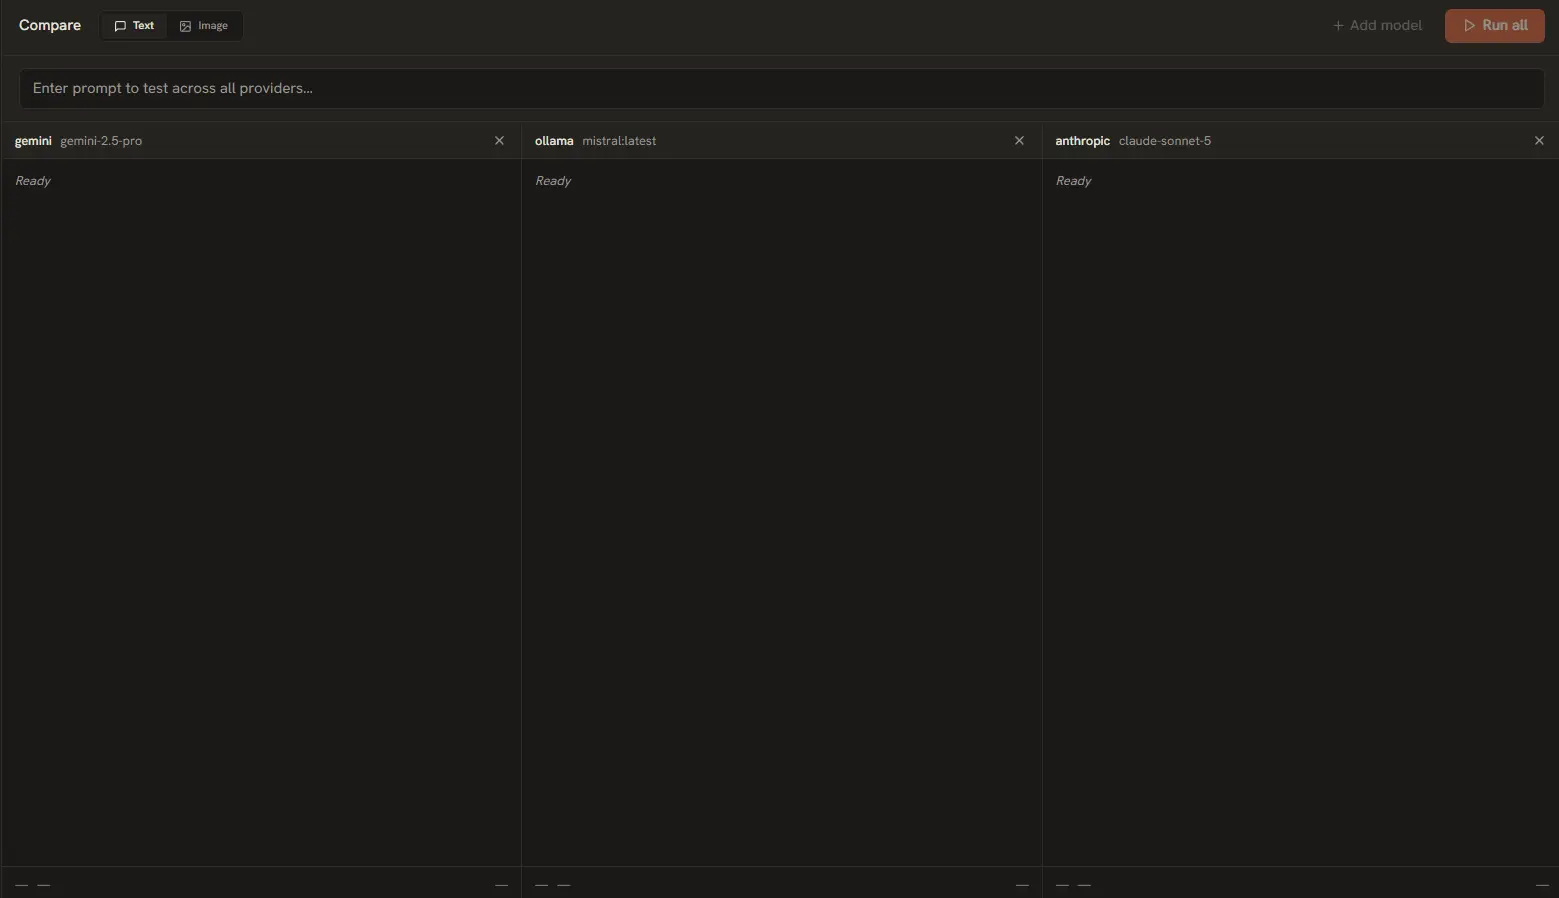
La función estrella de AI Playground es la interfaz de Comparar. En lugar de abrir varias pestañas del navegador y ejecutar prompts de uno en uno, puedes probar modelos lado a lado en una sola vista. Es esencial para optimizar costes, comparar calidad y medir velocidad.
Cuándo usar el modo comparación
El modo comparación es ideal para responder preguntas como:
- Coste frente a calidad: ¿vale GPT-4o 10 veces el precio de Gemini 2.0 Flash para mi tarea concreta?
- Velocidad: ¿qué modelo responde más rápido para aplicaciones en tiempo real?
- Formato de salida: ¿formatea JSON mejor Claude que GPT? ¿Sigue Gemini los prompts de sistema con más rigor?
- Selección de modelo: ¿qué modelo de código abierto vía Ollama se acerca más a un modelo de pago en la nube?
Configurar una comparación
Sigue estos pasos para tu primera comparación:
- Haz clic en el icono Comparar de la barra lateral (el icono de dos columnas).
- Elige modo Texto o Imagen con el conmutador de la parte superior derecha.
- Haz clic en + Añadir columna de modelo. Puedes añadir hasta 3 columnas.
- En cada columna configura: el Proveedor (OpenAI, Anthropic, Google…), el Modelo (gpt-4o, claude-3.5-sonnet…) y los parámetros individuales (Temperature, Max Tokens…) por columna.
- Escribe tu prompt en el cuadro de entrada compartido de la parte inferior.
- Pulsa Ejecutar para enviar el prompt a todas las columnas a la vez.
Consejo: configura cada columna con la misma Temperature y Max Tokens para una comparación justa. Varía los parámetros a propósito solo cuando pruebes configuraciones concretas.
Leer los resultados
Cuando todas las columnas terminen, tres métricas aparecen bajo cada respuesta:
Latencia de respuesta (ms)
- Tiempo hasta el primer token. Cuanto más bajo, mejor para chat en tiempo real. Muestra qué combinación proveedor/modelo responde más rápido por la red.
Análisis de coste
- Coste exacto de cada respuesta según el catálogo de precios en vivo. Muestra las tarifas por cada 1.000 tokens y el coste total según los tokens concretos de entrada/salida.
Valoración de calidad
- Indicadores visuales de la estructura de la salida: cumplimiento del formato, longitud de la respuesta y si el modelo siguió las instrucciones fielmente.
Guardar configuraciones de comparación
¿Encontraste una combinación ganadora? Guarda tu configuración para reutilizarla:
- Configura tus columnas con los proveedores, modelos y parámetros deseados.
- Haz clic en Guardar config en la parte superior de la vista Comparar.
- Ponle un nombre (p. ej. "GPT-4o vs Claude vs Gemini — generación de código").
- Las configuraciones guardadas aparecen en el desplegable Comparaciones guardadas para recargarlas con un clic.
Comparación multi-ronda
Puedes ejecutar varios prompts dentro de la misma sesión de comparación. Los resultados de cada ronda se conservan en el historial de columnas, lo que permite comparar cómo responden los distintos modelos a una serie de prompts relacionados. Úsalo para probar consistencia conversacional, seguimiento de instrucciones en varios turnos o refinamiento iterativo de prompts.