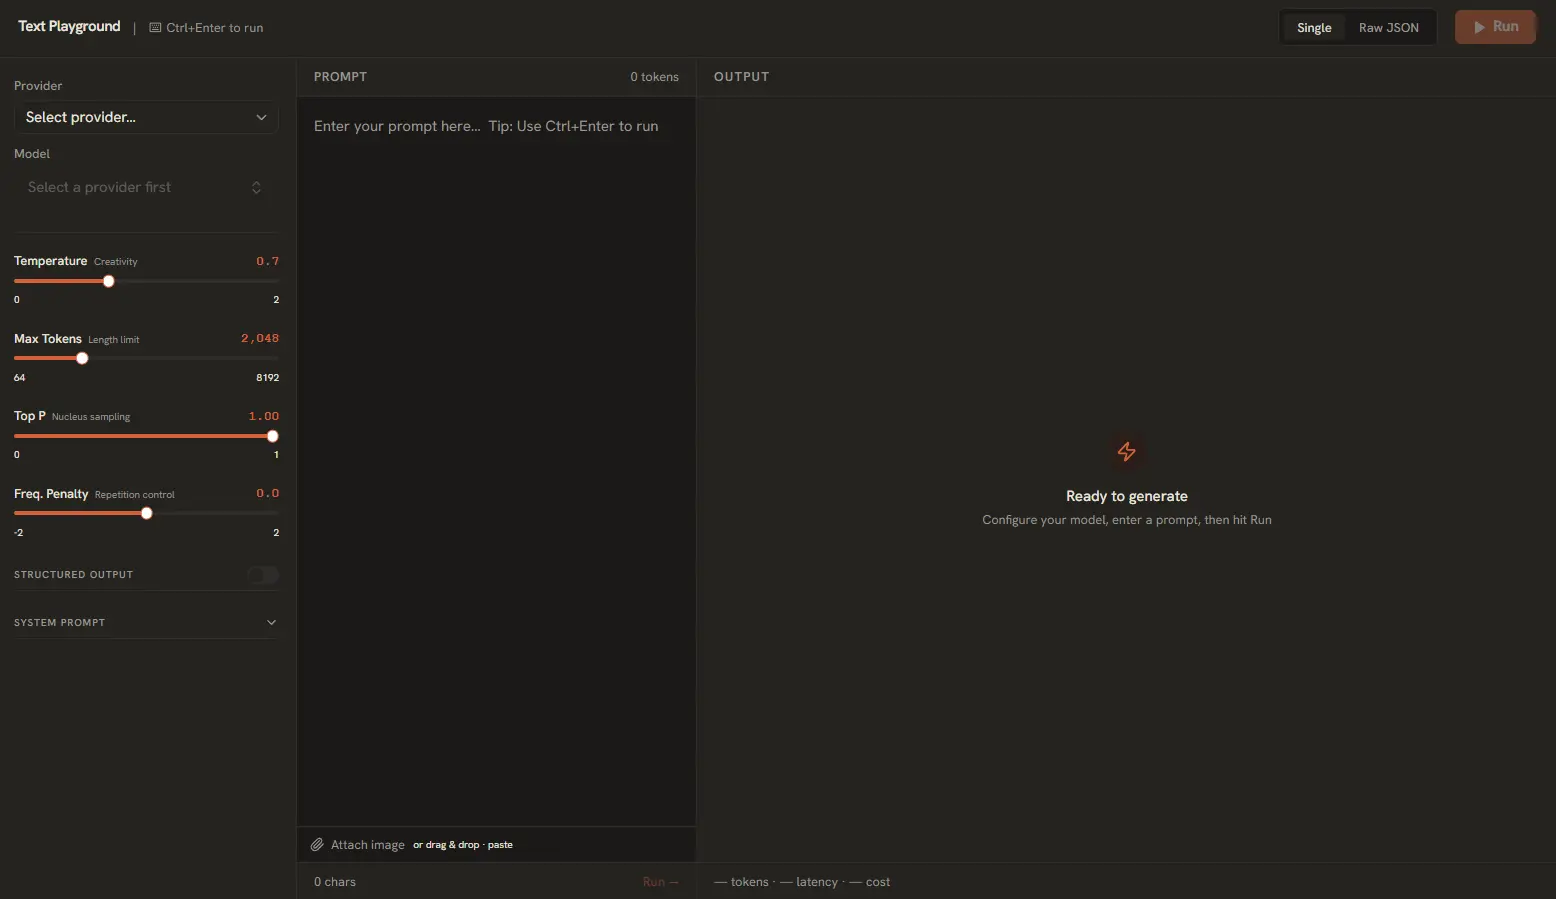
Der Textgenerator ist das Hauptwerkzeug in AI Playground. Er vereint Dutzende Modelle verschiedener Anbieter unter einer einzigen, konsistenten Oberfläche. Ob GPT-4o von OpenAI, Claude 3.5 von Anthropic, Gemini von Google oder ein lokales Ollama-Modell — das Erlebnis bleibt dasselbe.
Persistenter Multi-Turn-Chat
Standardmäßig unterstützt die Chat-Oberfläche persistente Mehrzug-Gespräche. Jede Nachricht behält den vollen Kontext des zuvor Gesagten — wie ChatGPT oder Claude im Web.
Chat-Steuerung:
- Neuer Chat: Startet ein frisches Gespräch und leert den Nachrichtenverlauf.
- Stopp: Bricht eine laufende Antwort ab. Nützlich, wenn das Modell sich verläuft.
- Wiederholen: Generiert die letzte Antwort mit einem neuen Zufalls-Seed neu.
- Kopieren: Kopiert die letzte Antwort in die Zwischenablage.
- Löschen: Entfernt einzelne Nachrichten aus der Konversation.
Chat-Verlauf verwalten
Alle Ihre Gespräche werden automatisch lokal gespeichert. Sie erreichen sie über die Verlaufs-Schublade in der linken Seitenleiste.
- Durchsuchen: Klicken Sie auf das Verlaufssymbol, um alle vergangenen Gespräche nach Datum sortiert zu sehen.
- Umbenennen: Klicken Sie auf das Stift-Symbol, um einem Gespräch einen eigenen Namen zu geben.
- Fortsetzen: Öffnen Sie ein vergangenes Gespräch und machen Sie genau dort weiter.
- Löschen: Entfernen Sie alte Gespräche, die Sie nicht mehr brauchen.
Sie können auch mitten im Gespräch das Modell wechseln — ändern Sie Anbieter oder Modell im Dropdown oben, ohne den Chat-Verlauf zu verlieren.
System-Prompts
Ein System-Prompt ist ein Satz grundlegender Anweisungen, der das Modellverhalten steuert, bevor es Ihre Nachrichten sieht. Aktivieren Sie das Feld über den Schalter System-Prompt oberhalb der Parameter-Steuerung.
„Du bist ein erfahrener Python-Engineer. Liefere nur Roh-Markdown-Codeausschnitte ohne Höflichkeitsfloskeln.“
System-Prompts sind ideal für:
- Rollenfestlegung: „Du bist ein professioneller Lektor.“
- Ausgabeformat: „Antworte immer im JSON-Format mit den Schlüsseln: answer, confidence, sources.“
- Verhaltensregeln: „Erwähne nie, dass du eine KI bist. Antworten unter 100 Wörtern.“
- Persona: „Du bist Sokrates. Beantworte jede Frage mit einer Gegenfrage.“
Parameter justieren
Das Konfigurations-Panel gibt Ihnen feine Kontrolle darüber, wie das Modell Text erzeugt. Diese Parameter gelten nur für die aktuelle Chat-Sitzung.
Temperature (0.0 - 2.0)
- Steuert die Zufälligkeit. Niedrige Werte (0.1-0.3) liefern fokussierte, deterministische Ausgaben — ideal für Code, Mathematik und Datenextraktion. Hohe Werte (1.0-2.0) steigern Kreativität und Vielfalt, nützlich für Brainstorming und kreatives Schreiben.
Top-P (0.0 - 1.0)
- Nucleus-Sampling. Ein Wert von 0.1 bedeutet, dass nur die 10 % wahrscheinlichsten Tokens berücksichtigt werden. Niedrige Werte fokussieren die Ausgabe. Best Practice: Temperature oder Top-P justieren, nicht beides gleichzeitig.
Max Tokens
- Die maximale Länge der generierten Antwort. Zählt Eingabe- und Ausgabetokens zusammen. Praktisch, um API-Kosten planbar zu halten und überlange Antworten zu vermeiden.
Frequency Penalty (0.0 - 2.0)
- Bestraft die Wiederholung derselben Wörter oder Phrasen. Höhere Werte reduzieren Wiederholungen und fördern abwechslungsreichen Wortschatz. Für technische Texte mit vielen Wiederholungen 0.5-1.0 einstellen.
Stop-Sequenzen
Stop-Sequenzen teilen dem Modell mit, wann es aufhören soll. Sie können eine oder mehrere im Parameter-Panel angeben:
- Einzelne Sequenz: Eine Zeichenkette wie
\n\neingeben, um an doppelten Zeilenumbrüchen zu stoppen. - Mehrere Sequenzen: Mehrere Stoppwörter mit Kommas trennen:
<|end|>, <|stop|>. - Anwendungsfall: Stop-Sequenzen sind essenziell für strukturierte Ausgaben wie JSON, XML oder Codegenerierung, wo Präzision zählt.
Streaming vs. Nicht-Streaming
AI Playground unterstützt zwei Auslieferungsmodi:
- Streaming (Standard): Die Antwort erscheint Token für Token, während sie generiert wird. Sie sehen Ergebnisse sofort und können jederzeit abbrechen. Ideal für interaktive Nutzung.
- Nicht-Streaming: Die vollständige Antwort kommt auf einen Schlag nach Abschluss der Generierung. Bis dahin sehen Sie nichts. Nützlich für automatisierte Workflows oder wenn Sie die komplette Ausgabe brauchen.
Antworten exportieren
Jede Antwort lässt sich über das Export-Menü (das Download-Symbol einer Antwort) in mehreren Formaten exportieren:
- Als Markdown kopieren: Kopiert die Antwort mit vollständigem Markdown-Formatting.
- Als Klartext kopieren: Entfernt sämtliche Formatierung für sauberes Einfügen.
- Als JSON kopieren: Exportiert das Roheantwort-Objekt inkl. Rolle, Inhalt, Token-Zahlen und Timing-Metadaten.