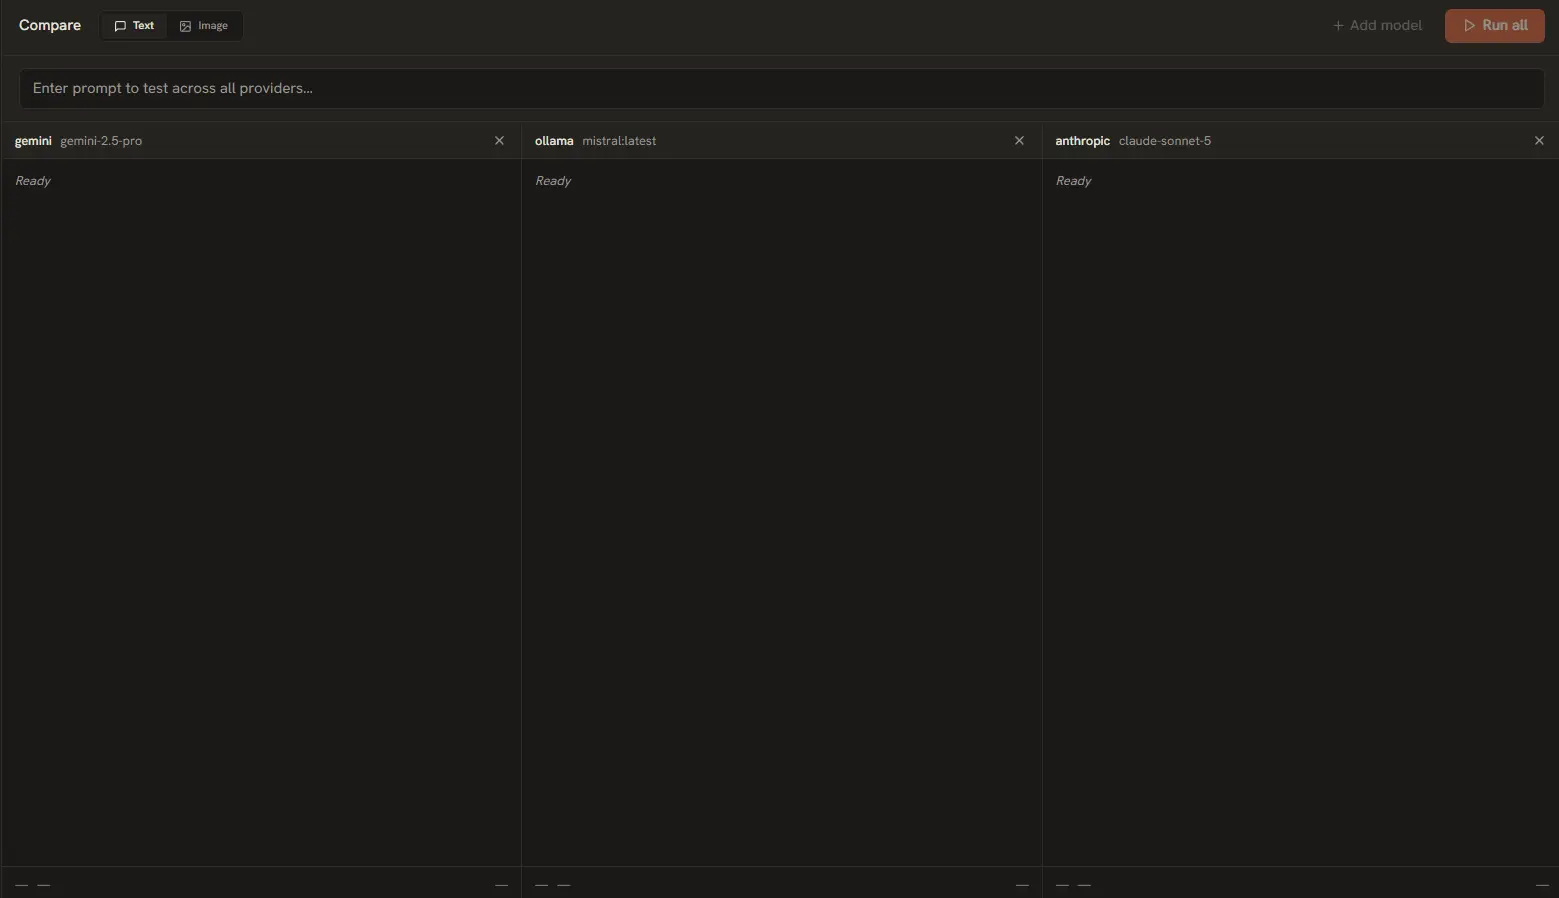
AI Playground 的招牌功能是对比界面。无需打开多个浏览器标签页逐个运行提示词,您可以在单一视图中并排测试模型。这对成本优化、质量评测和速度测试都至关重要。
何时使用对比模式
对比模式最适合回答这些问题:
- 成本 vs 质量:对我的具体任务而言,GPT-4o 是否值得以 10 倍于 Gemini 2.0 Flash 的价格使用?
- 速度:哪个模型对实时应用响应最快?
- 输出格式:Claude 的 JSON 格式是否比 GPT 更好?Gemini 是否更严格地遵循系统提示词?
- 模型选择:通过 Ollama 运行的哪个开源模型最接近付费云端模型?
设置一次对比
按照以下步骤进行您的第一次对比:
- 点击左侧边栏中的对比图标(双栏图标)。
- 通过右上角的开关选择文本或图像模式。
- 点击 + 添加模型列。最多可添加 3 列。
- 在每列中配置:服务商(如 OpenAI、Anthropic、Google)、模型(如 gpt-4o、claude-3.5-sonnet)以及每列独立的参数(Temperature、Max Tokens 等)。
- 在底部共享输入框中输入提示词。
- 点击运行,将提示词同时发送到所有列。
提示:为公平比较,请为每列设置相同的 Temperature 和 Max Tokens。只有在测试特定配置时才刻意改变参数。
解读结果
所有列生成完毕后,每条回复下方会出现三项指标:
响应延迟(毫秒)
- 到首个 token 的时间。越低越适合实时聊天。它显示哪家服务商/模型组合通过网络响应最快。
成本分析
- 根据实时价格目录计算每条回复的精确成本。显示每千 token 费率,以及按具体输入/输出 token 数计算的总成本。
质量评估
- 输出结构的可视化指标——格式合规性、回复长度,以及模型是否忠实遵循了指令。
保存对比配置
找到了最佳组合?保存对比配置以便复用:
- 使用所需的服务商、模型和参数配置各列。
- 点击对比视图顶部的保存配置按钮。
- 为其命名(如"GPT-4o vs Claude vs Gemini——代码生成")。
- 已保存的配置会出现在已保存的对比下拉框中,一键即可重新加载。
多轮对比
您可以在同一次对比会话中运行多个提示词。每轮的结果都会保留在列的历史中,便于比较不同模型对一系列相关提示词的响应。适合测试对话一致性、多轮指令遵循,或迭代优化提示词。